Привіт, мене звати Роман Повзик. Останні десять місяців працюю аналітиком даних у геймдев-компанії Bini Bambini. Та ще рік тому займався проєктним менеджментом у полтавській digital-агенції Yoda Consult, де працював 7 років. З початком повномасштабного вторгнення частина знайомих втратили роботу, оскільки або працювали у містах, де відбувалися бойові дії, або ж у їхніх сферах відчутно зменшилися обсяги продажів. Вони вирішили перевчитися або довчитися і рухатися в ІТ-сферу — зокрема у фронт-енді та дата аналітиці. Цей текст — спроба показати інструменти і техніки, які я використовував, коли переходив з digital-комунікацій в дата-аналітику, і які застосовую зараз.
Куди ти рухатимешся
Перш ніж розпочинати навчання, варто зрозуміти, чого саме хочеш досягти. Якщо робота в ІТ, то що саме це має бути: тут можна нарахувати десятки, якщо не сотні напрямків. Часто новачок боїться озвучити ціль, бо коли вона стає конкретною, є ризик, що не дійдеш до неї.
Один зі знайомих, який думає про перехід із бренд-менеджменту, досі не може зрозуміти, що йому цікавіше: маркетинг чи аналітика. Розвиватися в обох сферах важко, оскільки кожна вимагає багато часу для освоєння і має свої інструменти.
Ставлячи мету перед звільненням з попередньої роботи, я ставив чотири питання:
Чого ти хочеш? Отримати офер на посаду дата аналітика.
Якими метриками вимірятимеш ціль? Присвятити навчанню 1000 годин. Якщо працювати над цим 6-7 годин на день, це б мало зайняти 7 місяців у найгіршому випадку. Приділивши скільки часу, точно засвоїш базу і зробиш кілька pet-проєктів, які допоможуть виділитися.
Коли треба досягнути мети? У травні минулого року ставив собі за дедлайн 31 грудня. Це мотивувало не лежати на дивані, оскільки з кожним днем часу ставало менше, як і заощаджених коштів.
Який ризик, якщо не досягнеш? Цього питання не зустрінеш у методиках постановок цілей, але воно важливе. Якщо ти втрачаєш роботу і вкладаєш час у навчання, то ризик великий: проїсти заощадження і не отримати результату. Для мене це було сильним стимулом, моїм «батогом».
Одне з того, що допомагало протягом світчингу, — трекер часу. Цей інструмент поки що мої знайомі ігнорують, але я впевнений у його ефективності. Не вимірюючи навчальний час, не бачиш скільки вклався у нього за день, тиждень, місяць. Для мене ідеальним варіантом став Toggle Tracker, його безкоштовної версії вистачає для усіх потреб.
«1000 годин для навчання» для мене звучить гарно й амбітно. Хоч це й нагадує «правило 10 000 годин Градуела», але ідеться трішки про інше. За 1000 годин ти здобудеш навички, необхідні для початкового рівня. Але це повинна бути цілеспрямована робота над собою.
Як визначити вид світчингу, що тобі підходить
До війни я розглядав два підходи світчингу: поступовий і радикальний. Ці форми актуальні і нині.
Поступовий — коли щодня навчаєшся 1-2,5 години на день, поки основний об’єм часу приділяєш нинішній роботі чи університету. У людини лишається дохід і вона застрахована від невдачі. З мінусів — більша втома, адже на відпочинок та родину лишатиметься ще менше часу, ніж зазвичай. Це демотивуватиме.
Радикальний — коли приділяєш весь вільний час навчанню. Якщо раніше цей шлях був добровільний, то зараз стає вимушеним. Добре, якщо до цього була фінансова подушка безпеки, адже витрати на життя нікуди не зникли. З плюсів: втоми буде менше. Але з’явиться тривога: гарантій, що новачок отримає роботу, ніхто не дасть, а попит на джуна, м’яко кажучи, невисокий.
Мій радикальний шлях світчера почався після забігу на 30 км і розуміння готовності до довгого навчального «забігу»
Якщо нині все ж є змога обирати, то радив би почати з поступового шляху: щодня приділяти хоча б годинку, щоб вчити основи в обраній тобою сфері. Якщо захопить, то можна і довше.
Я обрав напрямком роботу з даними, вивчав ази Python, читав Kaggle та дивився влоги людей, які вже працювали в аналітиці та Data Science. І готував себе до радикального шляху.
Міні-курси на Kaggle дуже допомогли освоїти базовий рівень
Декого з моїх знайомих стримує той факт, що нинішня робота все ще приносить більше, ніж посада новачка. Тут немає правильних рішень: або погоджуєшся на менше і з часом компенсуєш втрачене зростанням оплати, або ж лишаєшся на стабільній (поки що) попередній роботі. Але як побачили за останні три місяці — ця стабільність може бути дуже хиткою.
Сам собі університет
Після розуміння цілей та часу на навчання, визнач, що саме збираєшся вчити. І для себе, і для знайомих я використовую такий алгоритм:
Поговорити зі знайомими, що вже у цій сфері. Їхні поради зекономлять час і дадуть розуміння, які саме технології використовують компанії. Наприклад, що саме варто вчити дата аналітику: Power BI, Tableau, Looker чи Google Data Studio?
Листи людям, яких не знаєш, але які мають авторитет. Особливо це зручно зараз, коли LinkedIn дав українцям безкоштовний Premium-акаунт на кілька місяців. Я і досі звертаюся з питаннями до людей, які мені цікаві, наприклад до грандмайстрів Kaggle, і отримую корисні поради. Гарантій, що ці люди дадуть відповідь, немає. Але вони точно це отримають.
YouTube-влоги з порадами щодо навчального плану у вашій сфері. Такий жанр відео доволі поширений — варто просто забити правильні ключові слова. Не варто зупинятися на одному влозі: подивись кілька і сформуй на основі тих дисциплін, курсів, тренажерів, які зустрічалися у багатьох з них.
Аналіз вакансій на ринку. Так, їх стало менше, ніж до війни, але це все ще великий обсяг інформації, який покаже, які саме знання шукають рекрутери. Djinni та DOU — для України, вкладка Jobs на Linkedin — для світу. Хоча тепер можна і навпаки.
Особисто моїм топом в аналізі даних став курс з Python на 4 місяці від Beetroot Academy, який розбавляв SQL, Power BI, Tableau, статистикою, практичною роботою з даними, англійською та активністю з пошуку роботи.
Коли найкраще вчитися
Це питання залежить від того шляху, який обираєш. Якщо світчитися поступово, то варіантів три: ранок, вечір, ранок + вечір. Все залежить від біоритмів та хобі. Мені складно вчитися зранку у будні, але набагато легше ввечері після пробіжки. Комусь — навпаки.
У випадку радикального шляху, можна вчитися, коли завгодно. Але все ж раджу використовувати час з 9 до 18, щоб все-таки був певний режим. Під час свого «добровільного безробіття» практикував спільні виходи з дружиною з дому: вона йшла на роботу, а я повертався додому за 10-15 хвилин, ніби на власний офіс.
Результати самонавчання минулого року, помісячно
І те ж у цьому році
Раджу пам’ятати про так званий снек-час. Тобто проміжки у 10-15 хвилин, які можна використати, щоб засвоїти щось нове. Наприклад, у черзі чи в транспорті. Якщо повітряна тривога зустрічає мене не вдома, то маю з собою додаток Udemy, й у сховищі дивлюся актуальний курс.
Звісно, код на телефоні писати складно, але послухати тему зі статистики чи теорії ймовірності цілком можливо.
Використовуйте мозок ощадливо
У перші тижні війни мені, як і багатьом знайомим, було складно сконцентруватися на роботі, не кажучи про навчання. Але поступово цей ресурс вдалося відвоювати у ресурсів з новинами.
Останні кілька років мені допомагає система Pomodoro: розподіляєш роботу у відрізки по 25 хв і потім 5 хв відпочиваєш. Це зручно у роботі з digital, коли маєш багато коротких задач.
Але у випадку дата-аналітики, особливо там, де йде робота з кодом, цей підхід не працював: пів години — надто мало для того, щоб в’їхати у задачу і придумати хороше рішення. Тому підхід, який працює для мене останній рік — 50/10: 50 хвилин сконцентрованого навчання чи роботи та 10 хвилин відпочинку. Разом це — година, щоб допомагає зручно моніторити, якщо починати цикл на початку години.
У ці 10 хвилин варто розвантажити голову і попрацювати руками: застелити ліжко, помити посуд, прибрати за котом. Соцмережі та новини теж стараюся дивитися тільки у цей проміжок. Хоча і розумію, що розфокусуватися це не дуже допомагає.
Навчитися «думати пальцями»
Друк наосліп — навичка, яка дуже допомагає, незалежно від майбутньої спеціалізації в ІТ. Це стосується і української, а особливо англійської, на якій писатимете код.
Ось як виглядає мій екран під час вивчення курсу SQL: зліва пояснення лектора, справа — я повторюю його код
Як би важко це не було на початку, згодом зекономить час, коли повторюватимете код за лектором. До того ж це може бути маленькою перемогою під час довгої дороги до світчингу.
Залученість у навчання — вже частина успіху
Чим краще ти залучиш себе до навчання — тим більше шансів, що все закінчиться позитивно. Мої підходи:
Проєктно-орієнтоване навчання. Наприклад, вивчаючи якусь мову чи технологію, відразу думай, як зможеш полегшити собі життя з її допомогою. Наприклад, я свого часу написав бота, який начитував заголовки з «Українською правди» і давав мені аудіофайл для пробіжок.
Повторення коду за вчителем. Жоден урок коду не має бути просто пасивно переглянутий. Твої пальці (а бажано, і мозок) теж мають працювати. До того ж це допомагає виявити моменти, коли у лектора все працює, а у тебе — ні (бо у нього, наприклад, була раніше встановлена бібліотека, про яку він не сказав). Також, якщо курс застарілий, то якісь з частин коду уже можуть не працювати і потрібно знайти рішення, як його замінити (для мене це було актуально з машинним навчанням).
Залишай коментарі у коді. Відкривши його уже через кілька днів, можеш не згадати алгоритм, який застосував. Тому вважай це допомогою собі у майбутньому. Та і людям, які оцінюватимуть технічні навички, буде зручніше переглядати твої репозиторії.
Що варто знати про «правило 10 000 годин»
Журналіст Малкольм Гладуел у книзі «Неординарні» розповів про «правило 10 000 годин». Якщо коротко: потрібно витратити стільки часу, щоб стати експертом міжнародного класу.
Та тут є хитрість. Потрібно вдосконалювати себе саме там, де є складнощі, а не просто постійно робити одне й те ж в надії, що це покращує навички. Наприклад, вивчивши базу SQL, варто розбиратися зі складнішими темами, типу процедур та віконних функцій, а не перепроходити цю базу на іншому курсі.
Варто пам’ятати про криву складності: матеріал треба підбирати так, щоб він був на межі поточних можливостей. Якщо освоюватимеш табличку множення у 31 рік — буде нудно. Якщо ж перемножуватимете матриці вперше за 10 років — занадто складно. Шукай середину.
Як перевірити свою готовність
Найкраща можливість перевірити знання — співбесіди. Оскільки може бути пастка нескінченності курсів, як це трапилося з моїм знайомим фронт-ендером. Йому здається, що він ще недостатньо знає для пошуку роботи. Цій неготовності уже більш як десять місяців.
Співбесіди — це стресова перевірка, але вона потрібна, щоб побачити слабкі сторони. Розумію, зараз дійти до співбесіди початківцю стало складніше, але все ж треба пробувати.
Після кожного технічного інтерв’ю раджу виписувати те, на чому були складнощі і детальніше це пропрацьовувати. Після кількох таких ітерацій набагато впевненіше себе почуватимеш.
Приклад зворотного зв’язку, після якого варто попрацювати над собою
Якщо все ж не можеш потрапити на справжню співбесіду, почни з легших варіантів. Перший — Pramp — безкоштовний сервіс, де двоє кандидатів англійською проводять співбесіди один з одним. Моїми партнерами стали дослідник з Единбурзького університету і колишня розробниця з Apple.
Другий — Interview Warmup від Google, який аналізує відповіді англійською і показує семантичний аналіз, допомагаючи побачити інсайти, типу використовування робочої термінології, найчастіше вживані слова тощо.
Як виглядає мій розклад у Pramp
Розклад, який створюєш ти
У школі та університеті розклад переважно нам подавали від керівництва. При світчингу ти сам собі формуєш його.
Я прихильник чергування дисциплін, щоб мозок перемикався між активностями. Наприклад, Python з математикою, SQL з Power BI, пошук роботи з англійською. Натомість один з моїх знайомих бере певну дисципліну і приділяє їй тиждень з ранку до вечора.
Твій розклад має підходити під можливості. Наприклад, якщо я навчаюся у вихідний, то мені простіше на початку дня писати код, а у другій половині — працювати з рутинними задачами.
Додаткове середовище для світчингу
Якщо все ж хочеш перейти в іншу сферу, то оточення повинно максимально цьому допомагати. Навіть якщо це не напряму навчає хард-навичкам.
Влоги спеціалістів цієї сфери. Вчиш дата-аналітику — дивишся дата аналітиків, вчиш бекенд — відповідно. Ніколи не знаєш, яка з їхніх порад знадобиться. Мій топ — Тіна Хуанг, у влогах якої можна знайти багато корисного для навчання.
Художня література. З юності захоплююся науковою фантастикою і вважаю, що це — ідеальний жанр для айтівця. Наприклад, Метавсесвіт, що у 1992 році Ніл Стівенсон описував у романі «Лавина», нині — одна з головних ідей майбутнього для технологічних компаній.
Що варто пам’ятати про своє фізичне оточення
Те, що довкола нас, не менш важливе за інформаційний простір. І його потрібно адаптувати під свої навчальні потреби.
Стоячий стіл. Одна з найкращих покупок для мене минулого року, оскільки допомагає розвантажувати спину, якщо довго сидиш. Тим паче під час повітряних тривог його зручно переносити у коридор, щоб далі працювати чи навчатися.
Відключення сповіщень. Без цього неможливо надовго заглибитися у задачу і війти у стан потоку. Єдині сповіщення, які не ризикую вимикати, — та ж повітряна тривога. Все решта може почекати мої 50 хв концентрації.
Вода. Якщо хочеш, щоб мозок ефективно працював, — напувай його достатньо.
Музика на навушники. Допомагає додатково зосередитися на завданні. Для мене звично слухати саундтреки без вокалу. Крім того, через певний час певні мелодії допоможуть швидко налаштовуватися на продуктивне навчання. Мій топ — Ханс Циммер.
Що варто запам’ятати на старті світчингу
Сформоване тобою середовище багато у чому визначатиме шанси отримати офер. Вебінари, мітапи, онлайн-знайомства зі спеціалістами, влоги. Чим більше довкола вас буде таких підсилювачів, тим краще.
Зрозумій, навіщо все це. Чітко визнач мету: отримати роботу, збільшити зарплатню, переїхати в інше місто чи країну, знайти компанію з крутою місією. Мені приємно від розуміння, що українська компанія, де я працюю, створює конкурентний міжнародний продукт. Ну і те, що математикою можна заробляти на життя.
Усі колись були джунами. Насолоджуйся цим часом: колись буде сумно побачити перші завдання. Нині статус світчера — перевага, ознака того, що можеш швидко адаптуватися до нової ролі.
Головна метрика — час навчання. Відстежуй, скільки приділяєш цьому часу і рухайся до мети.
Не порівнюй себе ні з ким. Це як з бігом: маєш дивитися лише на свої показники і прогрес. Головне — не зупинятися.
Я вірю, що навіть війна не зможе зупинити людину, яка вирішила відкрити для себе нову сферу. Так, це буде складніше, ніж раніше, але все ж можливо. Успіхів вам і оферів!
У третьому кварталі 2026 року оборонні компанії опублікували на DOU 3942 вакансії. Це близько 20% усіх пропозицій на платформі і рекорд за всі роки. Для hardware-фахівців показник теж рекордний: 704 вакансії за квартал, а на одну вакансію embedded-розробника в середньому припадає 4,6 відгуку (DOU, III квартал 2026). Компанії, які шукають «готового» інженера методами класичного IT, витрачають на це місяці. У статті зібрані дані ринку, цифри з нашого вебінару «Навчати чи наймати» з Мартою Хрип'як, HR Director Lira Engineering, і критерії, за якими варто вирішувати: шукати людину на ринку чи виростити її.
Скільки інженерів бракує Defence Tech у 2026 році
Попит на інженерів в оборонці росте швидше, ніж ринок встигає готувати людей. У 2025 році deftech-вакансій було в 2,6 раза більше, ніж у 2024-му. За перше півріччя 2026 року їх опублікували більше, ніж за весь 2025 рік. Кількість вакансій для hardware-фахівців з 2024 року зросла більш ніж ушестеро.
Наймати далі планують усі. У дослідженні Української ради зброярів і CORE Team усі 27 опитаних виробників збираються шукати людей найближчі 6–12 місяців, а майже половина називає найдефіцитнішими інженерів-конструкторів та інженерів з електроніки (AIN). Конструкторів шукають 67% виробників.
Найважче закрити ролі на стику заліза і коду:
Embedded
Firmware
FPGA
RF/EW
конструктори
інженери з електроніки
Частка embedded-вакансій в оборонці в 6–7 разів вища, ніж в IT (DOU). При цьому бракує не лише стеку. Як підкреслювала на вебінарі Марта Хрип'як-Стеценко, компаніям не вистачає інженерного мислення: уміння ухвалювати рішення в умовах невизначеності й відповідати за продукт.
Скільки триває пошук інженера в defence tech
Звичайну технічну роль в оборонці закривають за 1–2 місяці, критичну інженерну за 3–6 місяців і довше. Такі терміни Марта Хрип'як-Стеценко навела на вебінарі «Навчати чи наймати»:
Скільки в середньому триває пошук спеціаліста залежно від типу ролі
Тип ролі
Скільки триває пошук
Виробничі ролі
2–4 тижні
Звичайна технічна роль
1–2 місяці; близько 30% таких вакансій тягнуться понад 3 місяці
Критична інженерна роль
3–6+ місяців
Кілька цифр, які пояснюють, чому все так довго:
200–400 контактів потрібно, щоб зібрати якісний шорт-лист на інженерну роль. Це у 2–3 рази більше, ніж на інших позиціях.
На 31% довше закриваються вакансії в мілтеху порівняно з IT, а шлях від першого контакту до згоди на офер довший на 42%.
7 з 10 вакансій закривають кандидатом, якого знайшли в перші 10 днів пошуку.
Остання цифра найпрактичніша. Якщо за два тижні у воронці немає жодного близького кандидата, проблема, найімовірніше, у профілі вакансії. Продовжувати пошук з тими самими вимогами означає втрачати ще місяці.
Навіть коли кандидата знайдено, найм часто зривається на фініші. Серед типових причин: контрофер, безпекові перевірки, невизначеність із бронюванням, формат роботи, знижена ставка на випробувальний термін, зміна обов'язків або етапів у процесі і повільне рішення самої компанії.
Пошук «єдинорога»: чому ідеальний кандидат існує в одиницях
Більшість вакансій, які не закриваються місяцями, вимагають від однієї людини поєднання кількох рідкісних навичок. Кожну з них окремо на ринку знайти можна. Разом майже ніколи.
«Окремо знайти Senior Embedded — в принципі реально. Окремо знайти людину з досвідом у БПЛА — реально. Окремо знайти людину, яка знає англійську на рівні B2-C1 — реально. Але знайти сеньйора з досвідом БПЛА, з сильним системним дизайном, з англійською мовою і, наприклад, з готовністю працювати в мілтеху... це вже одиниці на всю країну».
Марта Хрип'як-Стеценко, HR Director, Lira Engineering
Перетин вимог лише одна з причин. Спікерка вебінару виділила ще кілька:
Малий і невидимий пул. Частина сильних інженерів «старої школи» працювала на промислових підприємствах, у НДІ, у радіоелектроніці. Профілю в LinkedIn у них часто немає, резюме на job-сайтах вони роками не оновлюють, тож сорсинг під IT їх просто не бачить.
Частина людей служить або перебуває за кордоном.
Пасивний ринок. Ті, хто вже працює в оборонці, рідко відповідають на вакансії самі.
Конкуренція з IT, телекомом і automotive за тих самих інженерів.
Бронювання більше не вирізняє. Його пропонують 74% компаній, тож для кандидата це вже стандарт.
Пул IT-фахівців цю проблему не закриває. У класичному IT окремі напрями збирають понад 80 відгуків на вакансію, тоді як у deftech середній показник за перше півріччя 2026 року становив 10,2 (RazomUA за даними DOU). І більшість цих відгуків іде на Project Manager, QA та DevOps.
Що змінилося на ринку найму за рік
Кандидатів стало ще менше, а підняття зарплат ситуацію не врятувало. Ось як Марта Хрип'як-Стеценко описала зміни на вебінарі:
Відгуків на вакансію наприкінці 2023 року було приблизно 15, наприкінці 2025-го близько 7. У 2026 році 0–4.
89% компаній переглянули зарплати на 10–20%, але легше не стало нікому.
Вимоги до кандидатів ростуть, вакансій для початківців меншає.
Мотивація кандидатів зсунулась від місії до бронювання і фінансових умов.
Висновок спікерки прямий: головна проблема в браку людей і конкуренції за той самий пул. Ставки тут вторинні.
Справжня ціна пошуку: чотири шари
Бюджет на рекрутера чи агенцію видно одразу. Решту витрат зазвичай не рахують, хоча вони більші:
Прямі витрати: рекрутер, агенція, платформи.
Час команди. Інтерв'ю забирають час наймаючих менеджерів і керівників, до 30% їхнього робочого часу йде на рекрутинг.
Ціна порожнього місця. Продукт або модифікація стоїть місяцями.
Ціна помилки: повторний цикл пошуку й онбордингу, якщо людина не підійшла.
Що роблять компанії, коли позиція не закривається
Оборонні компанії зазвичай пробують шість підходів. Лише один із них збільшує кількість інженерів у галузі.
Що роблять, коли пошук інженера затягується, і що це дає
Що роблять
Що це дає
Розбивають роль
Замість «єдинорога» двоє людей з вужчим профілем
Переманюють у конкурентів
Той самий інженер, інший офіс
Розширюють формат і географію
Більший пул, але ті самі обмеження
Перезапускають пошук, наймають агенцію
Ще кілька місяців і бюджет
Піднімають ставку
Ціна росте для всіх, пул лишається тим самим; підняття має сенс лише з реалістичним профілем
Беруть джуна чи міддла і виділяють наставника
Плюс один сильний інженер для галузі
Марта Хрип'як-Стеценко назвала це канібалізацією талантів. Коли компанія B переманює інженера в компанії A, у галузі як було вісім інженерів, так і лишилося вісім. Чийсь продукт зупинився, а ринкові зарплати піднялися для всіх. Вирощений інженер додає галузі ще одного фахівця. Збільшити пул може тільки навчання.
Знайти чи виростити: критерії рішення
Шукати на ринку варто, коли людина потрібна за тижні або йдеться про унікальну lead-роль. Вирощувати всередині, коли до потреби є 3–6 місяців, у кандидата є суміжна база, а в команді є ментор. Рішення залежить від трьох критеріїв:
Глибина експертизи: наскільки вузький профіль потрібен.
Наставник: чи є в команді людина, у якої буде на це час.
Терміновість: скільки часу лишається до моменту, коли роль має запрацювати.
Внутрішня підготовка працює, якщо в компанії є наставники з виділеним часом, документація, онбординг і прозора структура росту. Найчастіше бракує часу сеньйорів, плану розвитку ролі, відповідального за L&D і віри керівництва в окупність.
Частину цих прогалин закриває зовнішній освітній партнер. Він бере на себе базову програму, викладачів і практику на залізі, а специфіку продукту людина отримує вже всередині компанії. Кандидатів для такого навчання найкраще шукати серед розробників на C/C++, випускників електроніки, радіотехніки, мехатроніки і у власній команді.
Де шукати embedded- і hardware-інженерів поза job-сайтами
Офлайн-події та профільні медіа дають доступ до кандидатів, яких немає в онлайн-воронці:
Канали пошуку інженерів для оборонних компаній: формат і що це дає роботодавцю
Квартальна аналітика ринку, найбільша база deftech-вакансій
Ці канали розширюють охоплення, але кількість інженерів на ринку вони не збільшують.
Навчання інженерних команд з Beetroot Academy
Beetroot Academy готує інженерів для defence і dual-use. Ключова освітня програма Embedded Development триває п'ять місяців і поєднує заняття з викладачами-практиками з роботою на реальному залізі; команди можна навчати окремими місцями або виділеною групою.
Повний запис вебінару «Навчати чи наймати: як Defence-компанії закривають дефіцит інженерів» і умови для команд є на сторінці для Defence-компаній.
Розробник з embedded чи backend уже має половину того, що потрібно CV-інженеру: впевнений код, Git, розуміння продуктивності й обмежень системи. Добрати доведеться роботу з даними, основи нейромереж і звичку оцінювати модель метриками замість відчуття «наче працює». У зимовому опитуванні DOU частка Computer Vision Engineer серед дата-фахівців за пів року зросла з 2% до 4% (DOU).
Розберемо, що з твого бекграунду переноситься, чого бракує і як виглядає реалістичний маршрут переходу.
Що вже є в embedded-розробника
Embedded-інженер мислить буферами, тактами й кілобайтами. Для комп'ютерного зору це сильна позиція, бо зображення в пам'яті і є буфером: висота × ширина × канали, тип даних uint8.
Що переноситься напряму:
C/C++ і звичка рахувати, скільки пам'яті та часу займає кожна операція
розуміння latency і реального часу: кадр має бути оброблений до приходу наступного
робота з периферією та камерами на рівні інтерфейсів
Linux на одноплатних комп'ютерах
Саме цього бракує багатьом ML-спеціалістам. У вакансіях CV Engineer у defence-компаніях окремим пунктом стоїть оптимізація моделей під Jetson та інші embedded-платформи, а C++ значиться бажаною навичкою поруч із Python.
Чого бракує: Python як робочого інструменту для експериментів, PyTorch, розуміння того, як модель вчиться і чому помиляється.
Що вже є в backend-розробника
Backend-розробник приносить інженерну дисципліну навколо коду: тести, Docker, CI, API, версіонування. У CV цього часто не вистачає: модель натренували в ноутбуці, а як вона житиме в продакшені, ніхто не продумав.
Що переноситься:
Python, якщо ти пишеш на ньому, або будь-яка мова з досвідом від року
логування й моніторинг, які в CV перетворюються на моніторинг якості моделі
Чого бракує: відчуття заліза. Модель, яка видає 30 кадрів на секунду на серверній відеокарті, на пристрої може видати три. Бекендеру доводиться вчитися мислити обмеженнями пам'яті, енергії та нагріву.
Яка математика потрібна для computer vision
Менше, ніж здається. Щоб працювати з детекторами на практиці, вистачить:
масиви й матриці: форма, індексація, множення
згортка: що робить фільтр 3×3, проходячи по зображенню
градієнтний спуск на рівні ідеї: модель потроху змінює ваги, щоб зменшити помилку
базова статистика: середнє, розподіл, precision і recall
Лінійна алгебра й теорія ймовірностей на університетському рівні знадобляться, якщо підеш у дослідження або розробку нових архітектур. Для прикладних задач детекції, трекінгу й оптимізації більшість інженерів обходиться розумінням на рівні інтуїції і добирає глибину, коли конкретна задача цього вимагає.
Маршрут переходу: від пікселя до детектора на пристрої
Зображення як дані. NumPy, колірні простори, гістограми. Для embedded-розробника це день роботи, для бекендера тиждень.
Класичний CV в OpenCV. Фільтри, Canny, морфологія, контури. Розв'яжи одну задачу без нейромереж, наприклад підрахунок однакових деталей на фото.
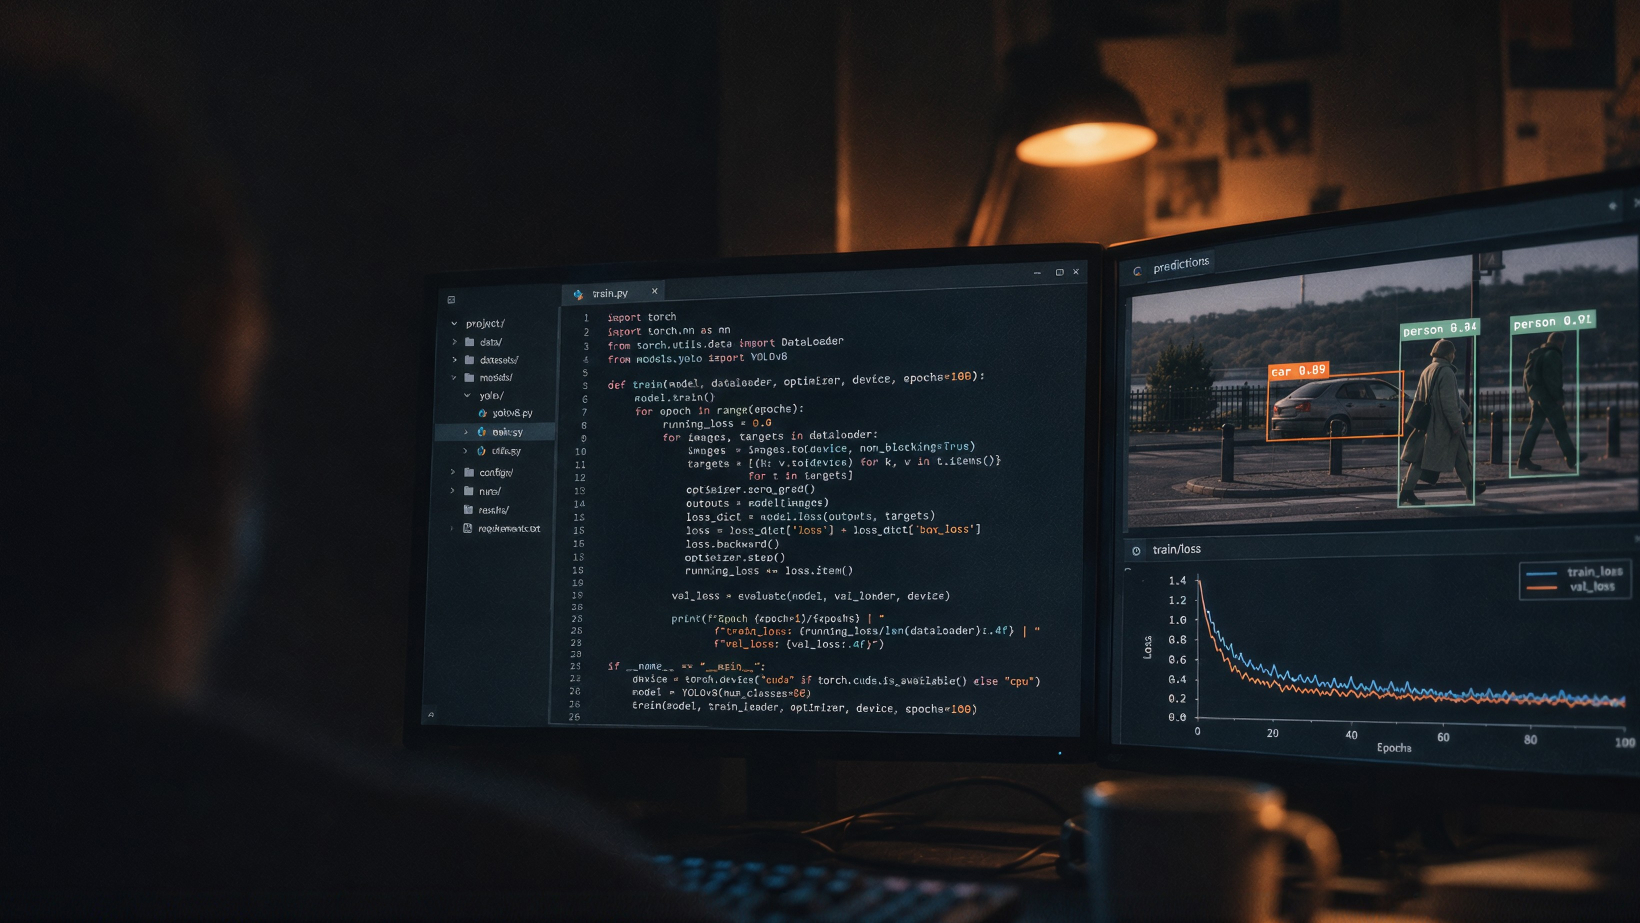
Нейромережі й transfer learning. Візьми готову модель, донавчи на кількох сотнях власних фото, подивись на криві train і validation.
Детекція з YOLO. Спочатку готова модель, потім навчання на власних даних з розміткою і метриками.
Друга ітерація. Знайди, де модель помиляється, дозбери дані, перетренуй. Саме тут видно, хто розуміє модель, а хто запускав туторіал.
Запуск на пристрої. Експорт в ONNX, квантизація, вимір швидкості на Raspberry Pi або Jetson.
Для embedded-розробника крок 6 буде найпростішим, а кроки 3–5 найновішими. У бекендера навпаки.
Перший проєкт для портфоліо
Роботодавець хоче побачити, як ти розв'язуєш задачу від початку до кінця. Висока точність на чужому датасеті цього не показує. Добрий проєкт має чотири складники: власний датасет, дві ітерації тренування з поясненням, що змінилося, таблицю метрик і запуск на реальному пристрої чи хоча б замір швидкості на CPU.
Ідеї, які можна зробити за кілька тижнів:
Проєкти для портфоліо та що кожен із них покаже роботодавцю
Проєкт
Що покаже роботодавцю
Детектор дефектів на деталях (подряпини, відколи)
роботу з малими об'єктами й незбалансованими класами
Підрахунок людей на вході через лінію
детекцію плюс трекінг
Розпізнавання хвороб рослин за фото листя
збір і розмітку власних даних
Читання показників лічильника
поєднання детекції й OCR
Будь-яка модель на Raspberry Pi з виміром FPS
розуміння edge-обмежень
Опиши проєкт у README так, як описав би технічне рішення колезі: задача, дані, що не спрацювало, що змінив, які цифри отримав.
Що просять у вакансіях Computer Vision Engineer
У вакансіях українських defence-компаній за 2026 рік повторюється приблизно однаковий набір:
Python впевнено, C++ як перевага
PyTorch і OpenCV
детекція, трекінг, сегментація
оптимізація під Jetson, ONNX, TensorRT
розуміння latency, FPS і пам'яті
Linux, Git, Docker
Наприклад, у вакансії Frontline Robotics, опублікованій у липні 2026 року, просили від трьох років досвіду в CV або ML. Це типово для ринку: вакансій для новачків у computer vision мало. Тому найреалістичніший шлях лежить через внутрішній перехід: ти лишаєшся розробником у своїй команді, береш CV-задачі, а за рік маєш комерційний досвід саме в цьому напрямі.
З чого почати
Освітня програма Computer Vision розрахована саме на розробників без ML-досвіду: від року програмування будь-якою мовою, 12 практичних занять, власний детектор і запуск на edge. Якщо ти з software і хочеш спершу розібратися із залізом, почни з Embedded Development.
Computer Vision Engineer створює системи для аналізу зображень і відео: від збору даних і тренування моделі до її роботи в продакшені чи на пристрої. Він поєднує машинне навчання з розробкою, тому в українських вакансіях від нього зазвичай чекають і PyTorch, і впевненого Python, і розуміння того, як модель поводиться на реальному залізі.
Нижче про задачі, стек, зарплати й шлях у професію, з опорою на вакансії 2026 року і дані DOU.
Що робить CV-інженер
Тренування моделі займає меншу частину роботи, ніж здається. Типовий цикл виглядає так:
Розібратися в задачі. Що саме треба знаходити, з якою точністю, на якій камері, з якою швидкістю.
Зібрати й розмітити дані. Узгодити правила розмітки, перевірити якість, поділити вибірки.
Обрати й навчити модель. Найчастіше це fine-tuning готового детектора; власну архітектуру з нуля пишуть рідко.
Проаналізувати помилки. Подивитися, де модель помиляється, і зрозуміти чому.
Оптимізувати й розгорнути. Експорт, квантизація, інтеграція у відеопайплайн чи сервіс.
Супроводжувати. Стежити, як модель працює на нових даних, дозбирувати приклади й перетреновувати.
Останній пункт часто недооцінюють. Модель, яка добре працювала в день запуску, через кілька місяців може гірше впоратися, бо змінилися освітлення, камера чи самі об'єкти. Це називають data drift, і відстежувати його входить в обов'язки CV-інженера.
Стек Computer Vision Engineer: що просять у вакансіях
Ми переглянули вакансії CV Engineer українських компаній за 2026 рік, зокрема Frontline Robotics і «Атлон Авіа». Повторюється такий набір:
Навички та інструменти у вимогах до спеціалістів з комп'ютерного зору і те, як часто вони трапляються
Що
Як часто трапляється
Python
обов'язково майже завжди
C++
обов'язково або як перевага
PyTorch
обов'язково
OpenCV
обов'язково або як перевага
Детекція, трекінг, сегментація
у задачах і вимогах
ONNX, TensorRT, OpenVINO
як перевага
NVIDIA Jetson та інші embedded-платформи
як перевага або в задачах
Linux, Git, Docker
обов'язково
GStreamer, DeepStream, робота з відеопотоком
як перевага
У вимогах Frontline Robotics, наприклад, окремо згадано розуміння real-time обмежень: latency, FPS, пам'ять і продуктивність. Це характерно для продуктових компаній, де модель працює на пристрої. В аутсорсі чи хмарних продуктах акцент зміщується на MLOps, API і масштабування.
Скільки заробляє Computer Vision Engineer в Україні
Окремої медіани для CV-інженерів у публічних дослідженнях немає. Найближчі дані дає зимове опитування дата-фахівців DOU 2026:
Медіана та її зміна за пів року для ролей ML/DL Engineer, AI Engineer і Data Scientist
Роль
Медіана
Зміна за пів року
ML/DL Engineer
$2350
−$775
AI Engineer
$2375
−$325
Data Scientist
$2700
−$300
Важливі застереження. Вибірка невелика: 332 фахівці на всі дата-ролі. Медіана не розбита за рівнями, тому в неї потрапляють і джуни, і сеньйори. І тренд за пів року був на зниження.
В оборонній галузі картина інша. За зарплатним звітом DOU літа 2026, розробники з Python у DefTech мають найвищу медіану серед мов: $4500 проти $3500 у розробників в ІТ загалом. CV-інженери в defence-компаніях зазвичай пишуть саме на Python, тож орієнтуватися варто на ці цифри, з поправкою на рівень.
Де працюють CV-інженери
Продуктові компанії зі споживчими застосунками: фільтри, редактори фото, розумні камери
Промисловість і логістика: контроль якості, підрахунок, сортування, складські роботи
Агротех: моніторинг посівів, сортування врожаю
Медтех: аналіз медичних знімків як допомога лікарю
Defence і dual-use: робототехніка, автономні системи, аналіз аерофото
Аутсорс і R&D-центри: проєкти для іноземних клієнтів у будь-якій із цих сфер
У зимовому опитуванні DOU частка CV-інженерів серед дата-фахівців за пів року подвоїлася, з 2% до 4%. Абсолютно це невелика група, але вона росте.
Junior, Middle, Senior: як виглядає зростання
Вакансій CV Engineer для людей без досвіду мало. У переглянутих вакансіях defence-компаній ішлося про три роки досвіду в CV або ML. Тому найчастіше в професію приходять з суміжних ролей.
Початковий рівень зазвичай виглядає як розробник у команді, який бере CV-задачі: підготовку даних, інтеграцію готової моделі, оптимізацію пайплайна.
Middle самостійно веде задачу від даних до розгортання й вміє пояснити, чому модель помиляється.
Senior обирає підхід і архітектуру під обмеження продукту, оцінює ризики й відповідає за якість моделі після запуску.
Як стати Computer Vision Engineer
Найкоротший шлях веде з розробки. Embedded-інженер приносить розуміння заліза й реального часу, backend-розробник приносить продакшен-дисципліну. Обом бракує роботи з даними й нейромережами. Покроковий маршрут ми описали в статті як embedded- або backend-розробнику перейти в computer vision.
Мінімум, з яким можна претендувати на CV-задачі:
Python, NumPy, OpenCV
PyTorch на рівні fine-tuning готових моделей
один детектор, навчений на власних даних, з двома ітераціями
метрики mAP, precision, recall і вміння пояснити їх щодо задачі
досвід запуску моделі на пристрої або хоча б експорту в ONNX із виміром швидкості
З чого почати
Освітня програма Computer Vision у Beetroot Academy веде розробників без ML-досвіду від обробки зображень до власного детектора, його супроводу після деплою і запуску на edge: 12 практичних занять. Загальний огляд напряму є в гайді Комп'ютерний зір: що це і як працює.
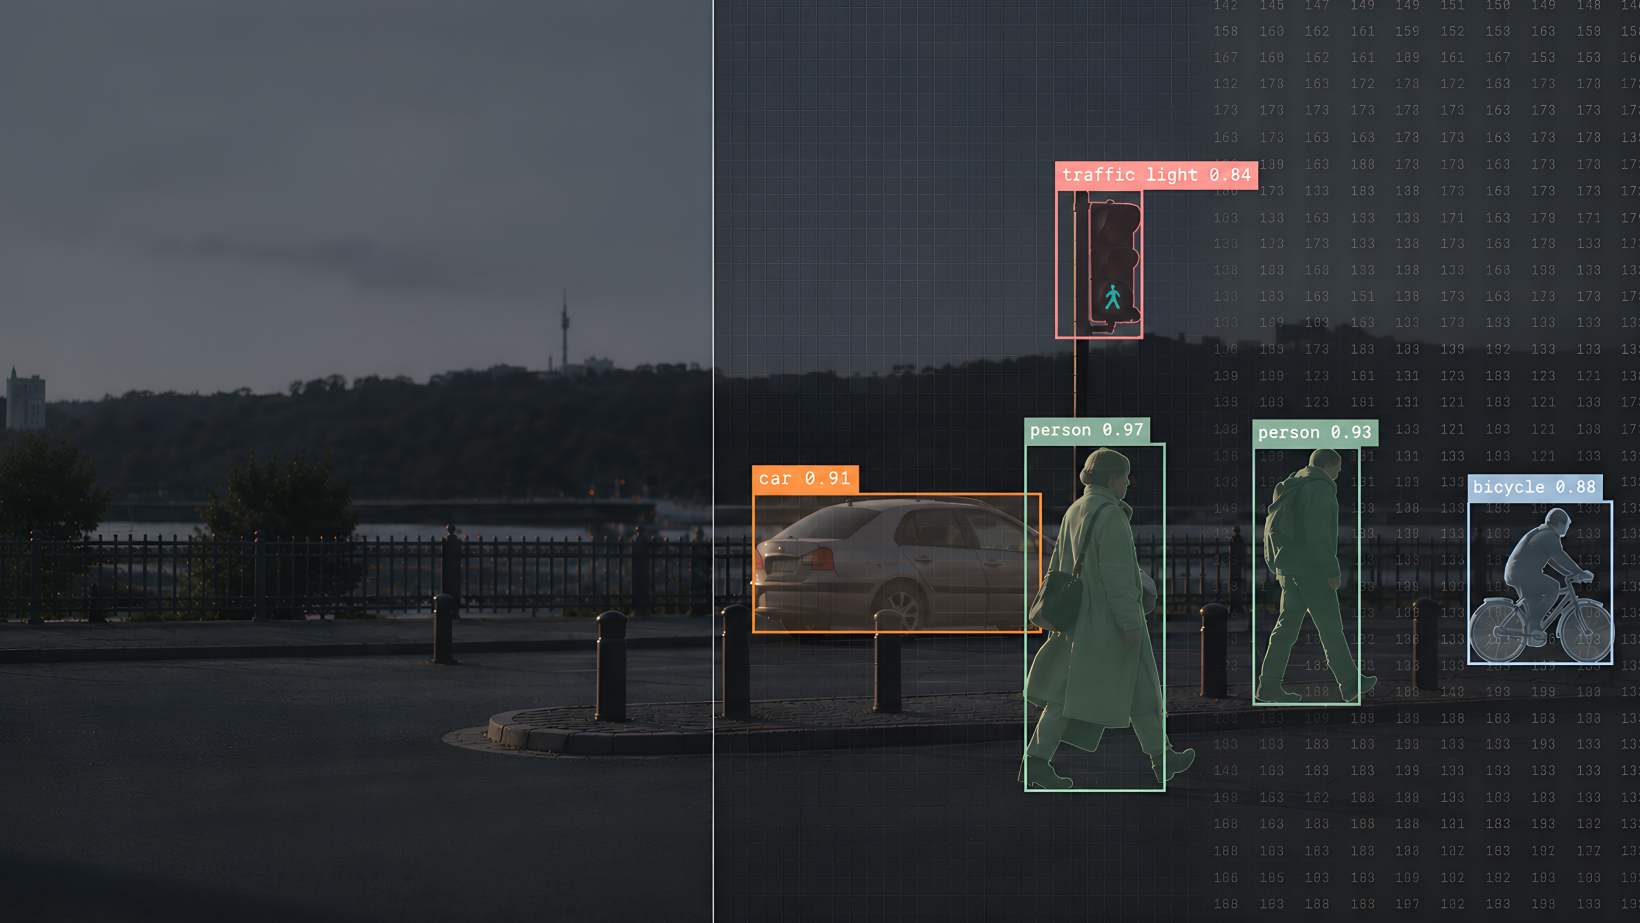
Комп'ютерний зір (computer vision, CV) є галуззю штучного інтелекту, яка вчить програми знаходити й розпізнавати об'єкти на зображеннях і відео. Камера дає лише масив чисел. Завдання CV полягає в тому, щоб перетворити ці числа на відповідь: що на кадрі, де саме і що з ним відбувається.
Нижче про те, як це працює, які задачі розв'язує комп'ютерний зір, де його вже використовують і як увійти в напрям, якщо ти пишеш код або працюєш із залізом.
Як комп'ютер «бачить» зображення
Для програми фото є таблицею чисел. Кольорове зображення 640×480 пікселів зберігається як масив 480×640×3: висота, ширина і три канали кольору. Кожне значення від 0 до 255 описує яскравість червоного, зеленого або синього в одній точці.
З цим масивом можна працювати двома способами.
Класичні алгоритми. Інженер сам описує правила: розмий шум, знайди краї, виділи контури, порахуй об'єкти. Цим займається бібліотека OpenCV. Такий підхід швидкий, передбачуваний і добре працює там, де умови стабільні: однакове освітлення, однаковий фон, однакові деталі на конвеєрі.
Нейромережі. Правила не пишуть вручну. Модель показують тисячі розмічених прикладів, і вона сама підбирає фільтри, які відрізняють один клас від іншого. Згорткова мережа (CNN) по суті робить те саме, що й класичний фільтр, тільки її ядра налаштовуються на даних. Сучасні детектори на кшталт YOLO та RT-DETR будуються на цьому принципі.
На практиці ці підходи поєднують. Нейромережа знаходить об'єкт, а класичний алгоритм уточнює його межі чи рахує розміри.
Які задачі розв'язує комп'ютерний зір
Основні задачі комп'ютерного зору: яке питання вирішує модель і приклад застосування
Задача
Питання, на яке відповідає модель
Приклад
Класифікація
Що на зображенні?
здоровий листок чи уражений
Детекція об'єктів
Що на кадрі і де саме?
рамки навколо людей на вході до магазину
Сегментація
Які саме пікселі належать об'єкту?
точний контур пухлини на знімку
Трекінг
Куди рухається об'єкт між кадрами?
підрахунок машин, що перетнули лінію
Оцінка пози
Як розташовані точки тіла?
аналіз техніки вправи в фітнес-застосунку
OCR
Який текст на зображенні?
читання номерів накладних на складі
Найчастіше в продуктах трапляються детекція і трекінг. Саме з них зазвичай починають навчання, бо результат видно одразу: рамка або з'являється на правильному місці, або ні.
Де використовують computer vision
Споживчі продукти. Фільтри, які накладають маски на обличчя, розумні камери, що відрізняють людину від кота, сканери документів у банківських застосунках. Частина таких продуктів створена в Україні: у програмі Computer Vision Beetroot Academy окремо розбирають кейси Looksery (згодом Snapchat), Reface, Ajax Systems і Petcube.
Промисловість. Контроль якості на лінії, де камера шукає подряпини й відколи швидше за людину. Підрахунок продукції, перевірка маркування, моніторинг безпеки на виробництві.
Агро. Виявлення хвороб рослин за фото листя, оцінка стану посівів з аерознімків, сортування врожаю.
Медицина. Допомога лікарю в аналізі рентгенівських і МРТ-знімків. Остаточне рішення тут ухвалює людина, а модель підсвічує ділянки, на які варто подивитися.
Робототехніка й dual-use. Автономні роботи, складські системи, аналіз аерофото і тепловізійних даних. Для інженера це ті самі алгоритми, тільки дані інші: кадр знято згори, об'єкти дрібні, а тепловізор дає одноканальне зображення замість кольорового.
Комп'ютерний зір, машинне навчання і AI: у чому різниця
Штучний інтелект є найширшим поняттям. Машинне навчання є його частиною: програми, які вчаться на даних замість прописаних правил. Комп'ютерний зір є прикладною областю, де машинне навчання застосовують до зображень і відео.
Звідси практичний висновок для кар'єри. CV Engineer зазвичай знає ML-основи, але глибоко працює з одним типом даних і з обмеженнями заліза, на якому модель має працювати. Детальніше про роль ми написали в статті Computer Vision Engineer: хто це і що робить.
Інструменти: OpenCV, PyTorch, YOLO, ONNX
Базовий набір, з яким працюють у більшості команд:
Python як основна мова для експериментів і тренування
OpenCV і NumPy для класичної обробки зображень
PyTorch для нейромереж
YOLO від Ultralytics для детекції, сегментації та трекінгу
Roboflow або CVAT для розмітки даних
ONNX, TensorRT, OpenVINO для запуску моделей на конкретному залізі
C++ там, де важлива швидкість на пристрої
Для старту достатньо Python і Google Colab: GPU для тренування Google надає безкоштовно, тож власна відеокарта на першому етапі не потрібна.
Що потрібно, щоб почати вивчати комп'ютерний зір
Найкоротший шлях має той, хто вже програмує. Досвіду з machine learning для старту не треба. Вища математика теж не є обов'язковою умовою: щоб працювати з детекторами, вистачить розуміння масивів і матриць, а складніші речі засвоюються на практиці.
Типова послідовність виглядає так:
Зображення як масив: канали, типи даних, колірні простори
Класичні операції в OpenCV: фільтри, краї, контури
Основи нейромереж і transfer learning
Детекція з YOLO на готових моделях, потім на власних даних
Метрики, аналіз помилок, друга ітерація тренування