Black Friday
16–27 листопада · −25% на повну оплату, −40% на перший платіж при помісячній оплаті
Logo Icon Beetroot Academy

Early Bird умови для нових знань

Забронюйте місце зараз — ціна фіксується на момент реєстрації.
до 25 Жовтня

-25%

до 1 Листопада

-15%

до 8 Листопада

–10%

Не знаєте, що обрати?

Ми поговоримо про різні можливості в ІТ й визначимо, як разом досягти ваших цілей
Ми зв'яжемося з вами якомога швидше в будні дні

Отримали вашу заявку!

Дякуємо, що цікавитесь навчанням в Beetroot Academy
Очікуйте дзвінок, ми зв'яжемося з вами протягом одного робочого дня і відповімо на усі запитання.
Вибачте, це технічна помилка. Спробуйте ще раз!
Або ви можете написати нам в Telegram
Якщо вам так зручніше, напишіть нам, відповімо якнайшвидше в робочі години

Ваш перший крок!

Залиште свої контакти, і ми зв'яжемось із вами, щоб розповісти більше про курс і допомогти стартувати.

Отримали вашу заявку!

На вашій пошті вже чекає наступний крок, тому не забудьте перевірити вхідні і розділ "спам".
‍
До зустрічі!
Вибачте, це технічна помилка. Спробуйте ще раз!

ШІ без жінок: як упередження кодуються в алгоритм

No items found.
Читати:
minutes
хв
26 лютого 2026
Наталія Кошовська
Радниця з питань інклюзії та гендерної рівності, програма RECONOMY, Helvetas
Поділитися в соцмережах
ШІ без жінок: як упередження кодуються в алгоритм
Жінки складають лише 22% фахівців у сфері ШІ у світі та 16% — в Україні. Коли технології розробляються без урахування різноманітних перспектив, вони відтворюють і посилюють існуючу нерівність. Ця стаття — про те, чому гендерна інклюзивність у ШІ є не лише питанням справедливості, а й економічною необхідністю.

ШІ формує світ, а хто формує ШІ?

Чи знали ви, що в усьому світі жінки складають лише близько 22% професіоналів у сфері розробки та впровадження штучного інтелекту (ШІ)? Такий гендерний розрив у навичках у сфері ШІ звужує потенціал для інновацій. Навіть коли цифрові технології стануть доступнішими, ця нерівність залишиться, якщо ми не змінимо гендерні соціальні норми.

В епоху цифрової трансформації штучний інтелект змінює індустрію, освіту та ринок праці. Однак гендерні упередження в освіті та впровадженні ШІ залишаються значною проблемою, що потенційно обмежує можливості для жінок зокрема. Жінки меншою мірою представлені в STEM-дисциплінах (наука, технології, інженерія та математика), що пов’язано з усталеними упередженнями про «чоловічі» та «жіночі» професії та відповідно формувало їхній вибір ще в дитинстві. Навіть згадайте свої шкільні підручники, чи багато ви там бачили реальних прикладів жінок у науці? Для наочності радимо подивитися експеримент у київській школі, де дітей попросили намалювати представників чотирьох професій – вірусологів, аеророзвідників, реаніматологів та рятувальників. Спойлер, усі діти намалювали чоловіків-представників заданих професій. Для України, яка прагне розвивати стабільну економіку попри поточні виклики, важливо забезпечити інклюзивний доступ до навчання без стереотипів, особливо у сфері штучного інтелекту – це сприятиме інноваціям, інклюзивному економічному зростанню та довгостроковій стійкості бізнесу.

Як пов'язані гендерна рівність та штучний інтелект

Системи штучного інтелекту працюють на основі даних, які в них завантажують. Якщо набори даних  містять упередження, які вже існують в суспільстві, ШІ може посилити гендерну нерівність та інші стереотипи — особливо під час наймання на роботу, доступу до фінансів та надання послуг з підтримки бізнесу. До прикладу, алгоритми штучного інтелекту, які використовуються для найму персоналу, можуть відтворювати упередження, віддаючи перевагу кандидатам-чоловікам у технічних чи керівних ролях. Аналогічно, якщо історичні дані містять дискримінацію за віком, ШІ може знижувати рейтинг кандидатів 45+ років, вважаючи їх менш гнучкими чи здатними до навчання.

У сфері кредитування алгоритми можуть автоматично знижувати шанси на отримання позик для підприємців-жінок або представників етнічних меншин, якщо в минулому такі групи мали менший доступ до фінансування.Це створює замкнене коло, де нерівність з минулого продовжує впливати на можливості в майбутньому.

Брак різноманітності в освіті зі штучного інтелекту та серед технічної робочої сили тільки загострює ці проблеми, залишаючи жінок та недостатньо представлені групи без права голосу у формуванні цифрової економіки. Їхні потреби, досвід і перспективи не враховуються при розробці алгоритмів, що призводить до створення технологій, які не відображають реальну різноманітність суспільства та можуть посилювати дискримінацію.

Сам по собі штучний інтелект може позитивно впливати на гендерну рівність. Наприклад, спеціально натреновані програми можуть підбирати працівників неупереджено, генерувати дані з розподілом за статтю, створювати кращі навчальні матеріали тощо. Агентний штучний інтелект, який не просто реагує, а активно допомагає, має потенціал революціонізувати домашню працю, автоматизуючи трудомісткі завдання та звільняючи жінок від непропорційного тягаря неоплаченої доглядової роботи. Жінки досі виконують у 2,5 раза більше домашніх обов’язків, ніж чоловіки, що обмежує їхню можливість займатися професійною або творчою діяльністю. Крім того, згідно з дослідженням у журналі Nature, штучний інтелект може допомогти досягти 79% цілей сталого розвитку ООН, тому світу потрібно більше фахівців у цій галузі.

Розвиток різноманітної та інклюзивної спільноти – це непросто мета, а необхідність. Різноманіття перспектив приносить нові ідеї та відкриття, які можуть трансформувати світ технологій і принести користь суспільству в цілому.

З появою глобальних етичних норм у сфері штучного інтелекту, на кшталт розроблених ЮНЕСКО, компанії, які активно протидіють гендерним упередженням, випереджатимуть регуляторні вимоги.

В Україні бізнес стрімко впроваджує рішення на основі штучного інтелекту, тому важливо забезпечити справедливий та рівний доступ до можливостей для всіх. Якщо не подолати гендерні упередження у сфері ШІ, то підприємства, очолювані жінками, ризикують отримувати менше фінансування та обмежений доступ до цифрових інструментів, що ще більше поглибить економічну нерівність.

Будьмо відвертими: залучення жінок до ШІ – це не просто створення голосового помічника з жіночим голосом; це буквально надання жінкам права голосу у сфері ШІ. Це означає забезпечення їхньої присутності в розробці ігор, зборі гендерночутливих даних, дослідницьких групах ШІ та навіть радах венчурного капіталу, де приймаються рішення про фінансування. У венчурному бізнесі жінкам складніше отримати фінансування, оскільки алгоритми, навчені на попередніх інвестиційних рішеннях, частіше віддають перевагу чоловічим командам, повторюючи упередження ринку. І самих жінок лише 5% серед венчурних інвесторів. Стартапи зі штучним інтелектом, очолювані жінками, стикаються зі значними розбіжностями в сумах фінансування, отримуючи в середньому в шість разів менше капіталу за угоду, ніж засновані чоловіками. Попри те, що глобальні дані показують, що стартапи, засновані жінками, генерують вищий дохід на кожен вкладений долар, ніж ті, які очолюють чоловіки.

Майбутнє екосистеми штучного інтелекту в Україні

Згідно зі звітом AI Ecosystem of Ukraine від AIHouse та Roosh, Україна має успішний ШІ-ландшафт із понад 150 стартапами ШІ та більш ніж 100 R&D-центрами. Україна посідає друге місце за кількістю ІТ-спеціалістів (307 000) серед країн Центральної та Східної Європи, тоді як кількість спеціалістів зі штучного інтелекту становить менш ніж 1%. Однак гендерна нерівність зберігається: жінки становлять лише 16% української робочої сили у сфері ШІ. Цей дисбаланс підкреслює необхідність цілеспрямованих заходів для сприяння гендерному розмаїттю в галузі ШІ-освіти та підприємництва.

У звіті підкреслюється, що український бізнес дедалі більше покладається на рішення на основі штучного інтелекту для автоматизації, аналізу даних та залучення клієнтів. Однак, якщо ці моделі ШІ навчаються на упереджених наборах даних або розробляються без гендерно-інклюзивних підходів, вони ризикують увічнити нерівність у сфері найму на роботу, фінансів та бізнес-операцій.

Прогнозується, що ринок аналітики в галузі штучного інтелекту стрімко розвиватиметься й досягне 223,32 мільярда доларів до 2034 року, що свідчить про зростальну залежність від прийняття рішень на основі штучного інтелекту в різних галузях промисловості. Також McKinsey оцінює, що генеративний ШІ може збільшити загальний економічний вплив ШІ на 15–40% та додати $2,6–$4,4 трлн щорічної вартості в різних сферах застосування, що свідчить про суттєве зростання продуктивності, обсягів виробництва та бізнес-цінності. Для української екосистеми штучного інтелекту це створює як можливості, так і виклики – без гендерно-інклюзивної освіти в галузі штучного інтелекту та вільної від упереджень розробки компанії ризикують посилити нерівність у сфері найму на роботу, фінансів та підприємницької діяльності. Щоби залишатися конкурентоспроможними та стійкими, українські компанії повинні надавати пріоритет різноманітним талантам у сфері ШІ, етичному впровадженню ШІ та інклюзивним бізнес-моделям, гарантуючи, що ШІ слугуватиме інструментом для справедливого економічного зростання, а не увічнення системних упереджень.

Висновок

Гендерна рівність та неупереджене навчання штучному інтелекту – це не лише етичні імперативи, а й економічна необхідність для сталого розвитку бізнесу в Україні. Розвиваючи інклюзивну освіту зі штучного інтелекту та усуваючи гендерні упередження в цифровій трансформації, Україна може побудувати більш стійку економіку, в якій інновації, справедливість та сталість є рушіями довгострокового успіху.

З огляду на вищезазначене, Швейцарська міжнародна організація Helvetas радо презентує рекомендації щодо відповідальних та інклюзивних стратегій у сфері штучного інтелекту для регіону Східного Партнерства, включно з Україною. Рекомендації спрямовані на державні установи, приватний сектор, громадянське суспільство та освітні установи. Розробка документа відбувалася у співпраці з організацією StrategEast та Help.

Також важливо зазначити такі проєкти з диджиталізації, на кшталт Beetroot Academy в Україні в рамках програми RECONOMY. Освітній продукт з ШІ надає компаніям та окремим особам, зокрема жінкам, навички, необхідні для процвітання в сучасній цифровій економіці, що сприяє інноваціям та інклюзивності. (лінк на відео)

RECONOMY – це програма, що реалізується Helvetas Swiss Intercooperation у партнерстві зі Шведським агентством міжнародного розвитку (Sida). Програма сприяє інклюзивному та зеленому економічному розвитку в регіонах Східного партнерства та Західних Балкан.

‍

Більше останніх новин

Читати:
minutes
хв
13 листопада 2026
Навчати чи наймати: як український Defence Tech закриває дефіцит інженерів

У третьому кварталі 2026 року оборонні компанії опублікували на DOU 3942 вакансії. Це близько 20% усіх пропозицій на платформі і рекорд за всі роки. Для hardware-фахівців показник теж рекордний: 704 вакансії за квартал, а на одну вакансію embedded-розробника в середньому припадає 4,6 відгуку (DOU, III квартал 2026). Компанії, які шукають «готового» інженера методами класичного IT, витрачають на це місяці. У статті зібрані дані ринку, цифри з нашого вебінару «Навчати чи наймати» з Мартою Хрип'як, HR Director Lira Engineering, і критерії, за якими варто вирішувати: шукати людину на ринку чи виростити її.

Скільки інженерів бракує Defence Tech у 2026 році

Попит на інженерів в оборонці росте швидше, ніж ринок встигає готувати людей. У 2025 році deftech-вакансій було в 2,6 раза більше, ніж у 2024-му. За перше півріччя 2026 року їх опублікували більше, ніж за весь 2025 рік. Кількість вакансій для hardware-фахівців з 2024 року зросла більш ніж ушестеро.

Наймати далі планують усі. У дослідженні Української ради зброярів і CORE Team усі 27 опитаних виробників збираються шукати людей найближчі 6–12 місяців, а майже половина називає найдефіцитнішими інженерів-конструкторів та інженерів з електроніки (AIN). Конструкторів шукають 67% виробників.

Найважче закрити ролі на стику заліза і коду:

  • Embedded
  • Firmware
  • FPGA
  • RF/EW
  • конструктори
  • інженери з електроніки

Частка embedded-вакансій в оборонці в 6–7 разів вища, ніж в IT (DOU). При цьому бракує не лише стеку. Як підкреслювала на вебінарі Марта Хрип'як-Стеценко, компаніям не вистачає інженерного мислення: уміння ухвалювати рішення в умовах невизначеності й відповідати за продукт.

Скільки триває пошук інженера в defence tech

Звичайну технічну роль в оборонці закривають за 1–2 місяці, критичну інженерну за 3–6 місяців і довше. Такі терміни Марта Хрип'як-Стеценко навела на вебінарі «Навчати чи наймати»:

Скільки в середньому триває пошук спеціаліста залежно від типу ролі
Тип ролі Скільки триває пошук
Виробничі ролі 2–4 тижні
Звичайна технічна роль 1–2 місяці; близько 30% таких вакансій тягнуться понад 3 місяці
Критична інженерна роль 3–6+ місяців

Кілька цифр, які пояснюють, чому все так довго:

  • 200–400 контактів потрібно, щоб зібрати якісний шорт-лист на інженерну роль. Це у 2–3 рази більше, ніж на інших позиціях.
  • На 31% довше закриваються вакансії в мілтеху порівняно з IT, а шлях від першого контакту до згоди на офер довший на 42%.
  • 7 з 10 вакансій закривають кандидатом, якого знайшли в перші 10 днів пошуку.

Остання цифра найпрактичніша. Якщо за два тижні у воронці немає жодного близького кандидата, проблема, найімовірніше, у профілі вакансії. Продовжувати пошук з тими самими вимогами означає втрачати ще місяці.

Навіть коли кандидата знайдено, найм часто зривається на фініші. Серед типових причин: контрофер, безпекові перевірки, невизначеність із бронюванням, формат роботи, знижена ставка на випробувальний термін, зміна обов'язків або етапів у процесі і повільне рішення самої компанії.

Пошук «єдинорога»: чому ідеальний кандидат існує в одиницях

Більшість вакансій, які не закриваються місяцями, вимагають від однієї людини поєднання кількох рідкісних навичок. Кожну з них окремо на ринку знайти можна. Разом майже ніколи.

«Окремо знайти Senior Embedded — в принципі реально. Окремо знайти людину з досвідом у БПЛА — реально. Окремо знайти людину, яка знає англійську на рівні B2-C1 — реально. Але знайти сеньйора з досвідом БПЛА, з сильним системним дизайном, з англійською мовою і, наприклад, з готовністю працювати в мілтеху... це вже одиниці на всю країну».

Марта Хрип'як-Стеценко, HR Director, Lira Engineering

Перетин вимог лише одна з причин. Спікерка вебінару виділила ще кілька:

  1. Малий і невидимий пул. Частина сильних інженерів «старої школи» працювала на промислових підприємствах, у НДІ, у радіоелектроніці. Профілю в LinkedIn у них часто немає, резюме на job-сайтах вони роками не оновлюють, тож сорсинг під IT їх просто не бачить.
  2. Частина людей служить або перебуває за кордоном.
  3. Пасивний ринок. Ті, хто вже працює в оборонці, рідко відповідають на вакансії самі.
  4. Конкуренція з IT, телекомом і automotive за тих самих інженерів.
  5. Бронювання більше не вирізняє. Його пропонують 74% компаній, тож для кандидата це вже стандарт.

Пул IT-фахівців цю проблему не закриває. У класичному IT окремі напрями збирають понад 80 відгуків на вакансію, тоді як у deftech середній показник за перше півріччя 2026 року становив 10,2 (RazomUA за даними DOU). І більшість цих відгуків іде на Project Manager, QA та DevOps.

Що змінилося на ринку найму за рік

Кандидатів стало ще менше, а підняття зарплат ситуацію не врятувало. Ось як Марта Хрип'як-Стеценко описала зміни на вебінарі:

  • Відгуків на вакансію наприкінці 2023 року було приблизно 15, наприкінці 2025-го близько 7. У 2026 році 0–4.
  • 89% компаній переглянули зарплати на 10–20%, але легше не стало нікому.
  • Вимоги до кандидатів ростуть, вакансій для початківців меншає.
  • Мотивація кандидатів зсунулась від місії до бронювання і фінансових умов.

Висновок спікерки прямий: головна проблема в браку людей і конкуренції за той самий пул. Ставки тут вторинні.

Справжня ціна пошуку: чотири шари

Бюджет на рекрутера чи агенцію видно одразу. Решту витрат зазвичай не рахують, хоча вони більші:

  1. Прямі витрати: рекрутер, агенція, платформи.
  2. Час команди. Інтерв'ю забирають час наймаючих менеджерів і керівників, до 30% їхнього робочого часу йде на рекрутинг.
  3. Ціна порожнього місця. Продукт або модифікація стоїть місяцями.
  4. Ціна помилки: повторний цикл пошуку й онбордингу, якщо людина не підійшла.

Що роблять компанії, коли позиція не закривається

Оборонні компанії зазвичай пробують шість підходів. Лише один із них збільшує кількість інженерів у галузі.

Що роблять, коли пошук інженера затягується, і що це дає
Що роблять Що це дає
Розбивають роль Замість «єдинорога» двоє людей з вужчим профілем
Переманюють у конкурентів Той самий інженер, інший офіс
Розширюють формат і географію Більший пул, але ті самі обмеження
Перезапускають пошук, наймають агенцію Ще кілька місяців і бюджет
Піднімають ставку Ціна росте для всіх, пул лишається тим самим; підняття має сенс лише з реалістичним профілем
Беруть джуна чи міддла і виділяють наставника Плюс один сильний інженер для галузі

Марта Хрип'як-Стеценко назвала це канібалізацією талантів. Коли компанія B переманює інженера в компанії A, у галузі як було вісім інженерів, так і лишилося вісім. Чийсь продукт зупинився, а ринкові зарплати піднялися для всіх. Вирощений інженер додає галузі ще одного фахівця. Збільшити пул може тільки навчання.

Знайти чи виростити: критерії рішення

Шукати на ринку варто, коли людина потрібна за тижні або йдеться про унікальну lead-роль. Вирощувати всередині, коли до потреби є 3–6 місяців, у кандидата є суміжна база, а в команді є ментор. Рішення залежить від трьох критеріїв:

  • Глибина експертизи: наскільки вузький профіль потрібен.
  • Наставник: чи є в команді людина, у якої буде на це час.
  • Терміновість: скільки часу лишається до моменту, коли роль має запрацювати.

Внутрішня підготовка працює, якщо в компанії є наставники з виділеним часом, документація, онбординг і прозора структура росту. Найчастіше бракує часу сеньйорів, плану розвитку ролі, відповідального за L&D і віри керівництва в окупність.

Частину цих прогалин закриває зовнішній освітній партнер. Він бере на себе базову програму, викладачів і практику на залізі, а специфіку продукту людина отримує вже всередині компанії. Кандидатів для такого навчання найкраще шукати серед розробників на C/C++, випускників електроніки, радіотехніки, мехатроніки і у власній команді.

Де шукати embedded- і hardware-інженерів поза job-сайтами

Офлайн-події та профільні медіа дають доступ до кандидатів, яких немає в онлайн-воронці:

Канали пошуку інженерів для оборонних компаній: формат і що це дає роботодавцю
Канал Формат Що дає роботодавцю
«Арсенал талантів» (DOU і Lobby X) Щорічний ярмарок вакансій у Києві Живий контакт із кандидатами; навесні 2026 року подія зібрала понад 4000 учасників
«Країна інженерів» (Lobby X) Серія miltech-хакатонів у регіонах, у 2025 році сім міст Інженери й студенти технічних спеціальностей поза Києвом
IT Arena Технологічна конференція у Львові, з 2025 року має окрему Defense-сцену Стенд із прототипами привертає IT-інженерів, які ще не розглядали оборонку
Defender Media Медіа про бізнес defence tech Календар галузевих подій і розділ вакансій
DOU DefTech Спільнота і розділ вакансій Квартальна аналітика ринку, найбільша база deftech-вакансій

Ці канали розширюють охоплення, але кількість інженерів на ринку вони не збільшують.

Навчання інженерних команд з Beetroot Academy

Beetroot Academy готує інженерів для defence і dual-use. Ключова освітня програма Embedded Development триває п'ять місяців і поєднує заняття з викладачами-практиками з роботою на реальному залізі; команди можна навчати окремими місцями або виділеною групою.

Повний запис вебінару «Навчати чи наймати: як Defence-компанії закривають дефіцит інженерів» і умови для команд є на сторінці для Defence-компаній.

Читати:
minutes
хв
12 листопада 2026
Як embedded- або backend-розробнику перейти в computer vision

Розробник з embedded чи backend уже має половину того, що потрібно CV-інженеру: впевнений код, Git, розуміння продуктивності й обмежень системи. Добрати доведеться роботу з даними, основи нейромереж і звичку оцінювати модель метриками замість відчуття «наче працює». У зимовому опитуванні DOU частка Computer Vision Engineer серед дата-фахівців за пів року зросла з 2% до 4% (DOU).

Розберемо, що з твого бекграунду переноситься, чого бракує і як виглядає реалістичний маршрут переходу.

Що вже є в embedded-розробника

Embedded-інженер мислить буферами, тактами й кілобайтами. Для комп'ютерного зору це сильна позиція, бо зображення в пам'яті і є буфером: висота × ширина × канали, тип даних uint8.

Що переноситься напряму:

  • C/C++ і звичка рахувати, скільки пам'яті та часу займає кожна операція
  • розуміння latency і реального часу: кадр має бути оброблений до приходу наступного
  • робота з периферією та камерами на рівні інтерфейсів
  • Linux на одноплатних комп'ютерах

Саме цього бракує багатьом ML-спеціалістам. У вакансіях CV Engineer у defence-компаніях окремим пунктом стоїть оптимізація моделей під Jetson та інші embedded-платформи, а C++ значиться бажаною навичкою поруч із Python.

Чого бракує: Python як робочого інструменту для експериментів, PyTorch, розуміння того, як модель вчиться і чому помиляється.

Що вже є в backend-розробника

Backend-розробник приносить інженерну дисципліну навколо коду: тести, Docker, CI, API, версіонування. У CV цього часто не вистачає: модель натренували в ноутбуці, а як вона житиме в продакшені, ніхто не продумав.

Що переноситься:

  • Python, якщо ти пишеш на ньому, або будь-яка мова з досвідом від року
  • Docker, Linux, Git
  • проєктування сервісів, черги, обробка потоку запитів
  • логування й моніторинг, які в CV перетворюються на моніторинг якості моделі

Чого бракує: відчуття заліза. Модель, яка видає 30 кадрів на секунду на серверній відеокарті, на пристрої може видати три. Бекендеру доводиться вчитися мислити обмеженнями пам'яті, енергії та нагріву.

Яка математика потрібна для computer vision

Менше, ніж здається. Щоб працювати з детекторами на практиці, вистачить:

  • масиви й матриці: форма, індексація, множення
  • згортка: що робить фільтр 3×3, проходячи по зображенню
  • градієнтний спуск на рівні ідеї: модель потроху змінює ваги, щоб зменшити помилку
  • базова статистика: середнє, розподіл, precision і recall

Лінійна алгебра й теорія ймовірностей на університетському рівні знадобляться, якщо підеш у дослідження або розробку нових архітектур. Для прикладних задач детекції, трекінгу й оптимізації більшість інженерів обходиться розумінням на рівні інтуїції і добирає глибину, коли конкретна задача цього вимагає.

Маршрут переходу: від пікселя до детектора на пристрої

  1. Зображення як дані. NumPy, колірні простори, гістограми. Для embedded-розробника це день роботи, для бекендера тиждень.
  2. Класичний CV в OpenCV. Фільтри, Canny, морфологія, контури. Розв'яжи одну задачу без нейромереж, наприклад підрахунок однакових деталей на фото.
  3. Нейромережі й transfer learning. Візьми готову модель, донавчи на кількох сотнях власних фото, подивись на криві train і validation.
  4. Детекція з YOLO. Спочатку готова модель, потім навчання на власних даних з розміткою і метриками.
  5. Друга ітерація. Знайди, де модель помиляється, дозбери дані, перетренуй. Саме тут видно, хто розуміє модель, а хто запускав туторіал.
  6. Запуск на пристрої. Експорт в ONNX, квантизація, вимір швидкості на Raspberry Pi або Jetson.

Для embedded-розробника крок 6 буде найпростішим, а кроки 3–5 найновішими. У бекендера навпаки.

Перший проєкт для портфоліо

Роботодавець хоче побачити, як ти розв'язуєш задачу від початку до кінця. Висока точність на чужому датасеті цього не показує. Добрий проєкт має чотири складники: власний датасет, дві ітерації тренування з поясненням, що змінилося, таблицю метрик і запуск на реальному пристрої чи хоча б замір швидкості на CPU.

Ідеї, які можна зробити за кілька тижнів:

Проєкти для портфоліо та що кожен із них покаже роботодавцю
Проєкт Що покаже роботодавцю
Детектор дефектів на деталях (подряпини, відколи) роботу з малими об'єктами й незбалансованими класами
Підрахунок людей на вході через лінію детекцію плюс трекінг
Розпізнавання хвороб рослин за фото листя збір і розмітку власних даних
Читання показників лічильника поєднання детекції й OCR
Будь-яка модель на Raspberry Pi з виміром FPS розуміння edge-обмежень

Опиши проєкт у README так, як описав би технічне рішення колезі: задача, дані, що не спрацювало, що змінив, які цифри отримав.

Що просять у вакансіях Computer Vision Engineer

У вакансіях українських defence-компаній за 2026 рік повторюється приблизно однаковий набір:

  • Python впевнено, C++ як перевага
  • PyTorch і OpenCV
  • детекція, трекінг, сегментація
  • оптимізація під Jetson, ONNX, TensorRT
  • розуміння latency, FPS і пам'яті
  • Linux, Git, Docker

Наприклад, у вакансії Frontline Robotics, опублікованій у липні 2026 року, просили від трьох років досвіду в CV або ML. Це типово для ринку: вакансій для новачків у computer vision мало. Тому найреалістичніший шлях лежить через внутрішній перехід: ти лишаєшся розробником у своїй команді, береш CV-задачі, а за рік маєш комерційний досвід саме в цьому напрямі.

З чого почати

Освітня програма Computer Vision розрахована саме на розробників без ML-досвіду: від року програмування будь-якою мовою, 12 практичних занять, власний детектор і запуск на edge. Якщо ти з software і хочеш спершу розібратися із залізом, почни з Embedded Development.

Читати:
minutes
хв
10 листопада 2026
Computer Vision Engineer: хто це, що робить і скільки заробляє

Computer Vision Engineer створює системи для аналізу зображень і відео: від збору даних і тренування моделі до її роботи в продакшені чи на пристрої. Він поєднує машинне навчання з розробкою, тому в українських вакансіях від нього зазвичай чекають і PyTorch, і впевненого Python, і розуміння того, як модель поводиться на реальному залізі.

Нижче про задачі, стек, зарплати й шлях у професію, з опорою на вакансії 2026 року і дані DOU.

Що робить CV-інженер

Тренування моделі займає меншу частину роботи, ніж здається. Типовий цикл виглядає так:

  1. Розібратися в задачі. Що саме треба знаходити, з якою точністю, на якій камері, з якою швидкістю.
  2. Зібрати й розмітити дані. Узгодити правила розмітки, перевірити якість, поділити вибірки.
  3. Обрати й навчити модель. Найчастіше це fine-tuning готового детектора; власну архітектуру з нуля пишуть рідко.
  4. Проаналізувати помилки. Подивитися, де модель помиляється, і зрозуміти чому.
  5. Оптимізувати й розгорнути. Експорт, квантизація, інтеграція у відеопайплайн чи сервіс.
  6. Супроводжувати. Стежити, як модель працює на нових даних, дозбирувати приклади й перетреновувати.

Останній пункт часто недооцінюють. Модель, яка добре працювала в день запуску, через кілька місяців може гірше впоратися, бо змінилися освітлення, камера чи самі об'єкти. Це називають data drift, і відстежувати його входить в обов'язки CV-інженера.

Стек Computer Vision Engineer: що просять у вакансіях

Ми переглянули вакансії CV Engineer українських компаній за 2026 рік, зокрема Frontline Robotics і «Атлон Авіа». Повторюється такий набір:

Навички та інструменти у вимогах до спеціалістів з комп'ютерного зору і те, як часто вони трапляються
Що Як часто трапляється
Python обов'язково майже завжди
C++ обов'язково або як перевага
PyTorch обов'язково
OpenCV обов'язково або як перевага
Детекція, трекінг, сегментація у задачах і вимогах
ONNX, TensorRT, OpenVINO як перевага
NVIDIA Jetson та інші embedded-платформи як перевага або в задачах
Linux, Git, Docker обов'язково
GStreamer, DeepStream, робота з відеопотоком як перевага

У вимогах Frontline Robotics, наприклад, окремо згадано розуміння real-time обмежень: latency, FPS, пам'ять і продуктивність. Це характерно для продуктових компаній, де модель працює на пристрої. В аутсорсі чи хмарних продуктах акцент зміщується на MLOps, API і масштабування.

Скільки заробляє Computer Vision Engineer в Україні

Окремої медіани для CV-інженерів у публічних дослідженнях немає. Найближчі дані дає зимове опитування дата-фахівців DOU 2026:

Медіана та її зміна за пів року для ролей ML/DL Engineer, AI Engineer і Data Scientist
Роль Медіана Зміна за пів року
ML/DL Engineer $2350 −$775
AI Engineer $2375 −$325
Data Scientist $2700 −$300

Важливі застереження. Вибірка невелика: 332 фахівці на всі дата-ролі. Медіана не розбита за рівнями, тому в неї потрапляють і джуни, і сеньйори. І тренд за пів року був на зниження.

В оборонній галузі картина інша. За зарплатним звітом DOU літа 2026, розробники з Python у DefTech мають найвищу медіану серед мов: $4500 проти $3500 у розробників в ІТ загалом. CV-інженери в defence-компаніях зазвичай пишуть саме на Python, тож орієнтуватися варто на ці цифри, з поправкою на рівень.

Де працюють CV-інженери

  • Продуктові компанії зі споживчими застосунками: фільтри, редактори фото, розумні камери
  • Промисловість і логістика: контроль якості, підрахунок, сортування, складські роботи
  • Агротех: моніторинг посівів, сортування врожаю
  • Медтех: аналіз медичних знімків як допомога лікарю
  • Defence і dual-use: робототехніка, автономні системи, аналіз аерофото
  • Аутсорс і R&D-центри: проєкти для іноземних клієнтів у будь-якій із цих сфер

У зимовому опитуванні DOU частка CV-інженерів серед дата-фахівців за пів року подвоїлася, з 2% до 4%. Абсолютно це невелика група, але вона росте.

Junior, Middle, Senior: як виглядає зростання

Вакансій CV Engineer для людей без досвіду мало. У переглянутих вакансіях defence-компаній ішлося про три роки досвіду в CV або ML. Тому найчастіше в професію приходять з суміжних ролей.

Початковий рівень зазвичай виглядає як розробник у команді, який бере CV-задачі: підготовку даних, інтеграцію готової моделі, оптимізацію пайплайна.

Middle самостійно веде задачу від даних до розгортання й вміє пояснити, чому модель помиляється.

Senior обирає підхід і архітектуру під обмеження продукту, оцінює ризики й відповідає за якість моделі після запуску.

Як стати Computer Vision Engineer

Найкоротший шлях веде з розробки. Embedded-інженер приносить розуміння заліза й реального часу, backend-розробник приносить продакшен-дисципліну. Обом бракує роботи з даними й нейромережами. Покроковий маршрут ми описали в статті як embedded- або backend-розробнику перейти в computer vision.

Мінімум, з яким можна претендувати на CV-задачі:

  • Python, NumPy, OpenCV
  • PyTorch на рівні fine-tuning готових моделей
  • один детектор, навчений на власних даних, з двома ітераціями
  • метрики mAP, precision, recall і вміння пояснити їх щодо задачі
  • досвід запуску моделі на пристрої або хоча б експорту в ONNX із виміром швидкості

З чого почати

Освітня програма Computer Vision у Beetroot Academy веде розробників без ML-досвіду від обробки зображень до власного детектора, його супроводу після деплою і запуску на edge: 12 практичних занять. Загальний огляд напряму є в гайді Комп'ютерний зір: що це і як працює.

Читати:
minutes
хв
4 листопада 2026
Комп'ютерний зір: що це, як працює і де застосовують

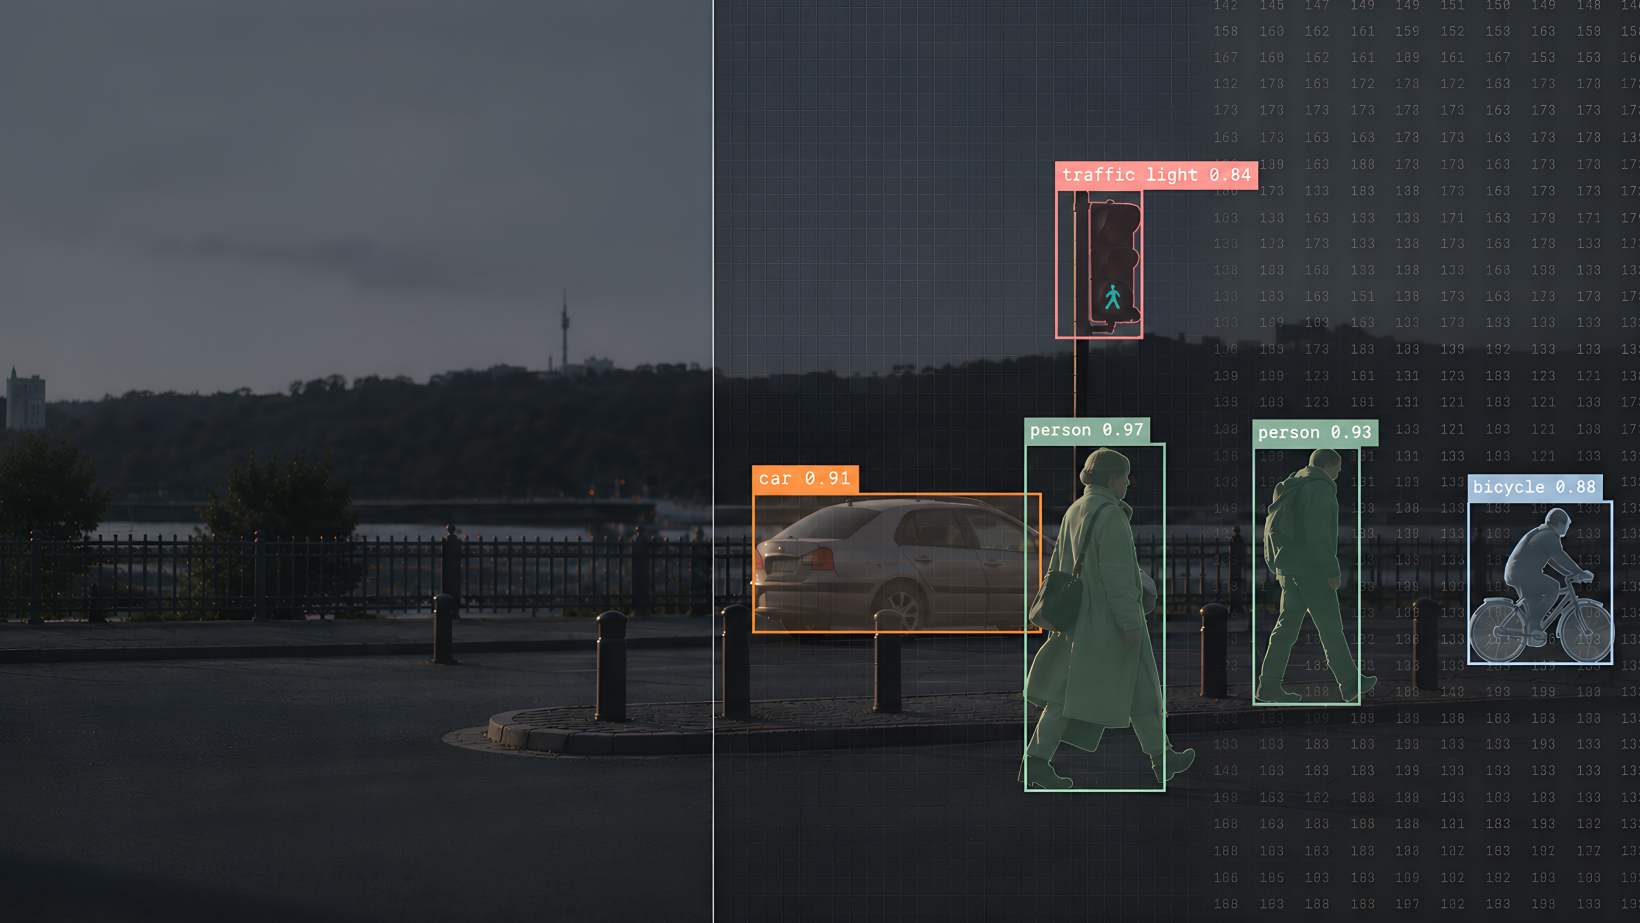
Комп'ютерний зір (computer vision, CV) є галуззю штучного інтелекту, яка вчить програми знаходити й розпізнавати об'єкти на зображеннях і відео. Камера дає лише масив чисел. Завдання CV полягає в тому, щоб перетворити ці числа на відповідь: що на кадрі, де саме і що з ним відбувається.

Нижче про те, як це працює, які задачі розв'язує комп'ютерний зір, де його вже використовують і як увійти в напрям, якщо ти пишеш код або працюєш із залізом.

Як комп'ютер «бачить» зображення

Для програми фото є таблицею чисел. Кольорове зображення 640×480 пікселів зберігається як масив 480×640×3: висота, ширина і три канали кольору. Кожне значення від 0 до 255 описує яскравість червоного, зеленого або синього в одній точці.

З цим масивом можна працювати двома способами.

Класичні алгоритми. Інженер сам описує правила: розмий шум, знайди краї, виділи контури, порахуй об'єкти. Цим займається бібліотека OpenCV. Такий підхід швидкий, передбачуваний і добре працює там, де умови стабільні: однакове освітлення, однаковий фон, однакові деталі на конвеєрі.

Нейромережі. Правила не пишуть вручну. Модель показують тисячі розмічених прикладів, і вона сама підбирає фільтри, які відрізняють один клас від іншого. Згорткова мережа (CNN) по суті робить те саме, що й класичний фільтр, тільки її ядра налаштовуються на даних. Сучасні детектори на кшталт YOLO та RT-DETR будуються на цьому принципі.

На практиці ці підходи поєднують. Нейромережа знаходить об'єкт, а класичний алгоритм уточнює його межі чи рахує розміри.

Які задачі розв'язує комп'ютерний зір

Основні задачі комп'ютерного зору: яке питання вирішує модель і приклад застосування
Задача Питання, на яке відповідає модель Приклад
Класифікація Що на зображенні? здоровий листок чи уражений
Детекція об'єктів Що на кадрі і де саме? рамки навколо людей на вході до магазину
Сегментація Які саме пікселі належать об'єкту? точний контур пухлини на знімку
Трекінг Куди рухається об'єкт між кадрами? підрахунок машин, що перетнули лінію
Оцінка пози Як розташовані точки тіла? аналіз техніки вправи в фітнес-застосунку
OCR Який текст на зображенні? читання номерів накладних на складі

Найчастіше в продуктах трапляються детекція і трекінг. Саме з них зазвичай починають навчання, бо результат видно одразу: рамка або з'являється на правильному місці, або ні.

Де використовують computer vision

Споживчі продукти. Фільтри, які накладають маски на обличчя, розумні камери, що відрізняють людину від кота, сканери документів у банківських застосунках. Частина таких продуктів створена в Україні: у програмі Computer Vision Beetroot Academy окремо розбирають кейси Looksery (згодом Snapchat), Reface, Ajax Systems і Petcube.

Промисловість. Контроль якості на лінії, де камера шукає подряпини й відколи швидше за людину. Підрахунок продукції, перевірка маркування, моніторинг безпеки на виробництві.

Агро. Виявлення хвороб рослин за фото листя, оцінка стану посівів з аерознімків, сортування врожаю.

Медицина. Допомога лікарю в аналізі рентгенівських і МРТ-знімків. Остаточне рішення тут ухвалює людина, а модель підсвічує ділянки, на які варто подивитися.

Робототехніка й dual-use. Автономні роботи, складські системи, аналіз аерофото і тепловізійних даних. Для інженера це ті самі алгоритми, тільки дані інші: кадр знято згори, об'єкти дрібні, а тепловізор дає одноканальне зображення замість кольорового.

Комп'ютерний зір, машинне навчання і AI: у чому різниця

Штучний інтелект є найширшим поняттям. Машинне навчання є його частиною: програми, які вчаться на даних замість прописаних правил. Комп'ютерний зір є прикладною областю, де машинне навчання застосовують до зображень і відео.

Звідси практичний висновок для кар'єри. CV Engineer зазвичай знає ML-основи, але глибоко працює з одним типом даних і з обмеженнями заліза, на якому модель має працювати. Детальніше про роль ми написали в статті Computer Vision Engineer: хто це і що робить.

Інструменти: OpenCV, PyTorch, YOLO, ONNX

Базовий набір, з яким працюють у більшості команд:

  • Python як основна мова для експериментів і тренування
  • OpenCV і NumPy для класичної обробки зображень
  • PyTorch для нейромереж
  • YOLO від Ultralytics для детекції, сегментації та трекінгу
  • Roboflow або CVAT для розмітки даних
  • ONNX, TensorRT, OpenVINO для запуску моделей на конкретному залізі
  • C++ там, де важлива швидкість на пристрої

Для старту достатньо Python і Google Colab: GPU для тренування Google надає безкоштовно, тож власна відеокарта на першому етапі не потрібна.

Що потрібно, щоб почати вивчати комп'ютерний зір

Найкоротший шлях має той, хто вже програмує. Досвіду з machine learning для старту не треба. Вища математика теж не є обов'язковою умовою: щоб працювати з детекторами, вистачить розуміння масивів і матриць, а складніші речі засвоюються на практиці.

Типова послідовність виглядає так:

  1. Зображення як масив: канали, типи даних, колірні простори
  2. Класичні операції в OpenCV: фільтри, краї, контури
  3. Основи нейромереж і transfer learning
  4. Детекція з YOLO на готових моделях, потім на власних даних
  5. Метрики, аналіз помилок, друга ітерація тренування
  6. Експорт моделі та запуск на пристрої

Один із цих кроків ми розібрали у окремій статті, як embedded- або backend-розробнику перейти в computer vision.

Перейти в блог

Популярні питання та відповіді